


مقدمه
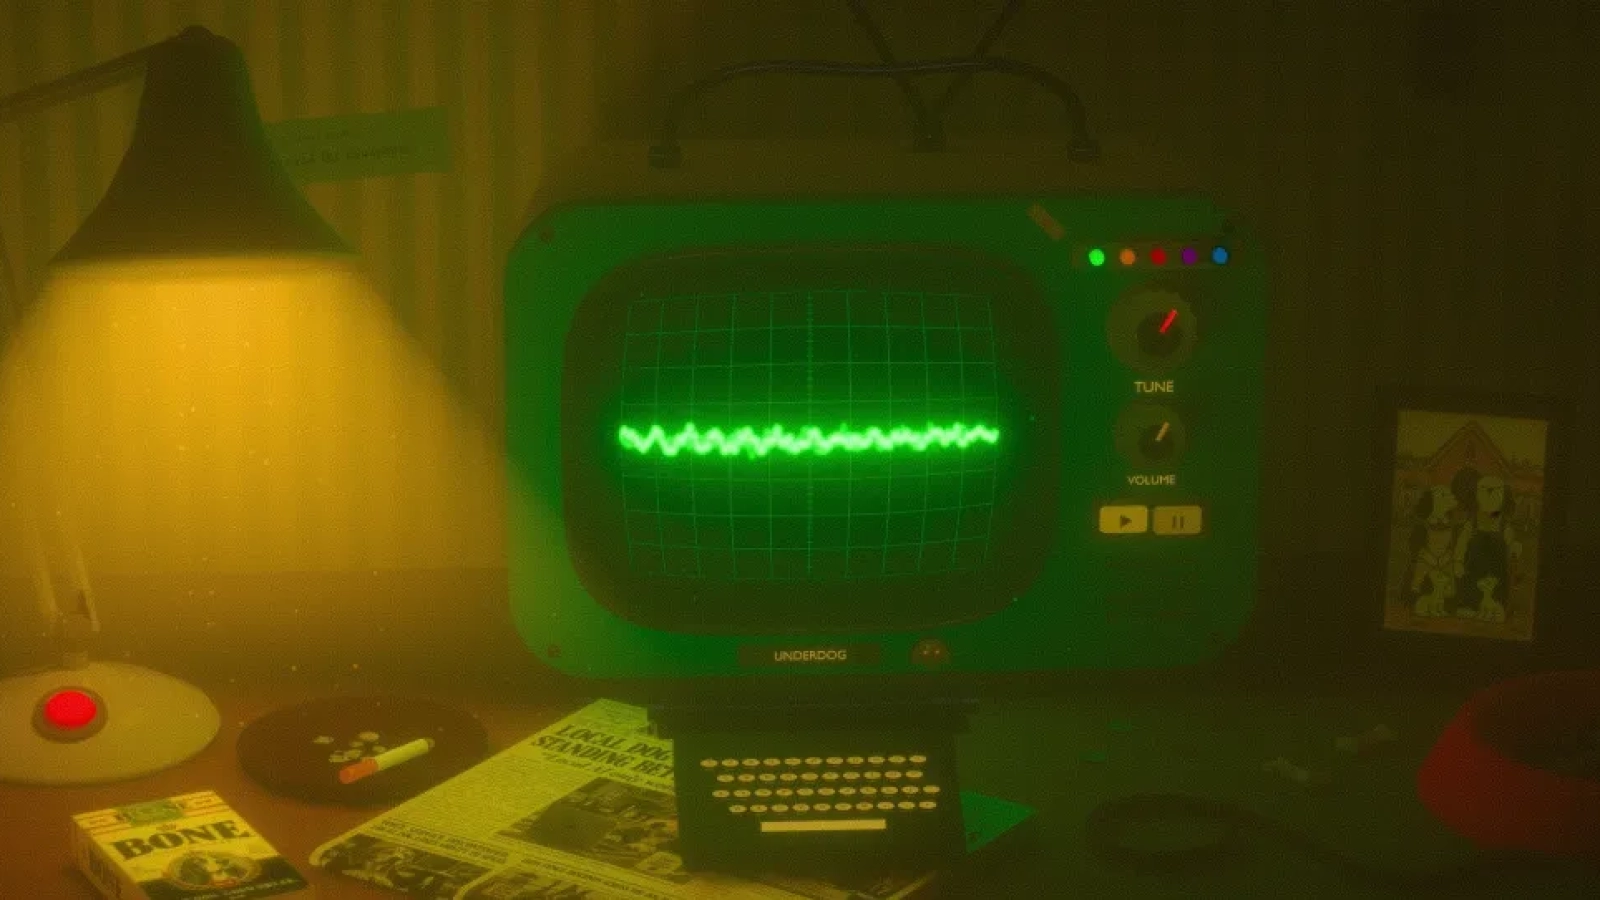
در دنیای هوش مصنوعی، اندازه و حجم مدلهای یادگیری عمیق همواره معیار مهمی برای توانایی اجرایی و کاربردی آنها محسوب میشود. اخیراً شرکت Underdog مدلی برای پردازش گفتار به حجم تنها 32 مگابایت ارائه کرده که در عین کوچک بودن، قادر به تولید هر دو خروجی صوتی از نوع گفتار و موسیقی است. این نوآوری توجه گستردهای را در حوزههای فناوری و کسبوکار جلب کرده است. بررسی این مدل کوچک اما کارآمد، چشماندازی جدید از نحوه توسعه و بهکارگیری فناوریهای هوش مصنوعی در سازمانها فراهم میآورد.
معرفی موضوع
مدلهای گفتار مبتنی بر هوش مصنوعی معمولاً حجم بالایی دارند و به منابع محاسباتی گسترده نیازمندند. در این میان، توسعه مدلی با حجم کم 32 مگابایت که هم گفتار و هم موسیقی تولید میکند، به نوعی پیشرفت بسیار مهم در این حوزه محسوب میشود. این مدل که توسط Underdog عرضه شده است، با کاهش چشمگیر حجم در عین حفظ کارایی، پتانسیلهای جدیدی برای بهرهبرداری در دستگاهها و پلتفرمهای مختلف ایجاد میکند. توانایی تولید موسیقی علاوه بر گفتار، انعطافپذیری بیشتری به کاربردهای خلاقانه و تجاری میبخشد.
چرا این اتفاق مهم است؟
حجم بالای مدلهای هوش مصنوعی، نوعاً مانعی برای استقرار آنها در محیطهای با محدودیت منابع است. این مساله به خصوص در دستگاههای لبهای، موبایلها و تجهیزات صنعتی که منابع سختافزاری محدودی دارند، محسوستر است. حمل و نقل، بهروزرسانی و اجرای این مدلهای بزرگ، هزینه و زمان زیادی میطلبد. بنابراین، ارائه مدلی کوچک و کارآمد که بتواند به سرعت و با مصرف منابع کمتر عمل کند، موضوعی حیاتی برای گسترش استفاده عملی از هوش مصنوعی در همه سطوح است.
این مدل کوچک نه تنها امکان پردازش سریعتر و بهینهتر را فراهم میآورد، بلکه در تسهیل توسعه برنامههای تعاملی مبتنی بر صدا، آموزشهای هوشمند و تولید محتوای صوتی نیز تاثیرگذار خواهد بود. همچنین، این مدل میتواند بهراحتی روی دستگاههای متنوع نصب شود و نیازی به اتصال مستمر به سرورها ندارد که اعتماد و امنیت دادهها را افزایش میدهد.
تأثیر بر کسبوکار
کسبوکارها به دنبال راههایی هستند تا خدمات هوشمند صوتی را با کمترین هزینه و بیشترین بازدهی ارائه دهند. مدل 32 مگابایتی Underdog با توانایی تولید گفتار و موسیقی قادر است در حوزههای متنوعی از جمله خدمات مشتری، بازاریابی صوتی، آموزشهای الکترونیکی و تعاملات انسانی-ماشینی بهرهبرداری شود.
کاهش حجم مدل به معنای کاهش هزینههای زیرساختی است. این امکان، کسبوکارها را قادر میسازد تا خدمات خود را به دستگاههای بیشتری عرضه کنند، از گوشیهای هوشمند گرفته تا دستگاههای IoT. همچنین، پردازش محلی صدا باعث افزایش سرعت پاسخگویی سیستم و کاهش وابستگی به اینترنت میشود که در حوزههای حساس مانند بانکداری و خدمات بهداشتی اهمیت خاصی دارد.
توانایی تولید موسیقی نیز میتواند منبعی برای خلق تجربههای صوتی منحصر به فرد باشد، که در تبلیغات و محتوا سازی دیجیتال ارزش افزوده ایجاد میکند. کسبوکارها با بهرهگیری از چنین فناوریهایی میتوانند تعامل بهتری با مشتریان خود برقرار کنند و نوآوری در محصولات داشته باشند.
نکات کلیدی
- بهینهسازی حجم مدل: حجم 32 مگابایتی باعث میشود مدل در دستگاههای با منابع محدود به خوبی اجرا شود و هزینههای ذخیرهسازی و انتقال داده کاهش یابد.
- دو عملکرد در یک مدل: تولید همزمان گفتار و موسیقی انعطافپذیری بیشتری در کاربردهای مختلف ایجاد میکند.
- اجرای محلی: امکان پردازش محلی به کاهش تأخیر، افزایش امنیت و استقلال از اتصال مداوم به اینترنت کمک میکند.
- کاربردهای چندگانه: از خدمات مشتری تا تبلیغات صوتی و آموزش هوشمند، طیف گستردهای از استفادههای تجاری و سازمانی برای این مدل وجود دارد.
درسهایی برای کسبوکارهای ایرانی
کسبوکارهای ایرانی، که اغلب با محدودیتهای زیرساختی و محاسباتی مواجه هستند، میتوانند از این نوع مدلهای سبک و بهینه بهرهمند شوند. استفاده از این فناوری نه تنها در بهبود کیفیت خدمات صوتی نقش دارد، بلکه به کاهش هزینهها و افزایش استقلال فناوری نیز کمک میکند.
همچنین این مدل میتواند فرصت مناسبی برای شرکتهای حوزه فناوری اطلاعات و نرمافزار در ایران باشد تا محصولات بومی مبتنی بر هوش مصنوعی تولید کنند که قابلیت اجرا در دستگاههای محلی را دارا باشند. توجه به نوآوریهای مشابه و سرمایهگذاری در بهینهسازی مدلها، زمینهای برای رشد پایدار در عرصه دیجیتال فراهم میکند.
آینده این حوزه
پیشبینی میشود روند کاهش حجم مدلهای هوش مصنوعی و افزایش کارایی آنها ادامه داشته باشد. مدلی مانند نمونه Underdog میتواند الگویی برای توسعه نسل جدیدی از سامانههای صوتی هوشمند باشد که ارزانتر، سریعتر و قابل حملتر هستند.
افزایش توانایی تولید محتواهای متنوع در حوزه صوت، از جمله گفتار تا موسیقی، میتواند به گسترش کاربردهای خلاقانه و تجاری کمک کند. ترکیب این فناوری با سایر قابلیتهای هوش مصنوعی، مانند درک احساسات و پاسخهای هوشمند، چشمانداز تعامل انسان و ماشین را متحول خواهد کرد.
جمعبندی
مدل گفتار 32 مگابایتی Underdog نمونهای از پیشرفتهای مهم در حوزه هوش مصنوعی است که نشان میدهد توانمندیهای فناوری در سایز کوچک نیز میتواند چشمگیر باشد. این مدل با امکان تولید هم گفتار و هم موسیقی، تغییرات قابل توجهی در نحوه اجرای فناوریهای صوتی به وجود میآورد و فرصتهای جدیدی برای کسبوکارها ایجاد میکند.
برای سازمانها، پذیرش چنین فناوریهایی به معنی کاهش هزینهها، بهبود کیفیت خدمات و افزایش قابلیت رقابت در بازارهای دیجیتال خواهد بود. کسبوکارهای ایرانی نیز با مطالعه و بکارگیری این دستاوردها میتوانند در مسیر توسعه دیجیتال گامهای موثر بردارند و با شرایط محدود هم به موفقیتهای ملموس دست یابند.
منبع و اخبار بیشتر:
techcrunch.com
دیدگاه شما چیست؟